AfeyGu/dsh-compaction-tower ↗★ 4
dsh-compaction-tower
Layered background distillation for DeepSeek Harness: distill early history ahead of time, commit whole blocks with zero LLM calls, and expose decompress/search_context to the model
Install
$
npx -p @deepseek-ai/dsh dsh plugin --profile web add github:AfeyGu/dsh-compaction-towerREADME
Read the full README ↗配置
主要是比例,随上下文窗口自适应(也可以在插件页的表单里改,见「配置界面」):
| 键 | 默认 | 含义 |
|---|---|---|
triggerRatio | 0.45 | 请求压力过此比例才提交 |
targetRatio | 0.15 | 提交后希望降到的水平(尽力而为) |
distillMinRunRatio | 0.05 | 一个「单位」:一次蒸馏/合并的材料量占可用预算的比例。不足不动手,够了就切一块 |
retainRecentGroups | 10 | 最近 N 个 step(一次模型请求 = 一步)永不压缩 |
observerMaxTokens | 200000 | 绝对保险丝(单块上限);正常单块等于上面的单位,只有单个节点超大时才会碰到它 |
observerProvider | '' | 观察者(蒸馏)用的 provider,空 = 跟随会话 |
observerModel | '' | 观察者(蒸馏)用的 model,空 = 跟随会话 |
observerTimeoutMs | 120000 | 单次蒸馏超时 |
summaryPromptMode | host | 蒸馏提示词三档:host(宿主英文原文)/ zh(中文同结构)/ custom(自己写) |
summaryPrompt | '' | 自定义蒸馏提示词,仅 custom 档生效;留空退回宿主 |
summaryMaxTokens | 200000 | 中文版 / 自定义档那次摘要请求的输出上限(保险丝);别调小,撞上限会让整块作废。0 = 不传,用模型自己的输出上限 |
observerConcurrency | 10 | 一次最多同时发起几个蒸馏 |
inlineMaxRatio | 0.02 | 解压内容内联的阈值(占窗口比例) |
hardMaxTokens | 40000 | 单次解压的绝对上限 |
exportKeepSessions | 20 | 保留最近 N 个导出会话目录 |
mergeMinBlocks | 2 | 一次合并的块数下限;真正的门槛是同层 checkpoint 要累加到窗口的 5% |
配置界面
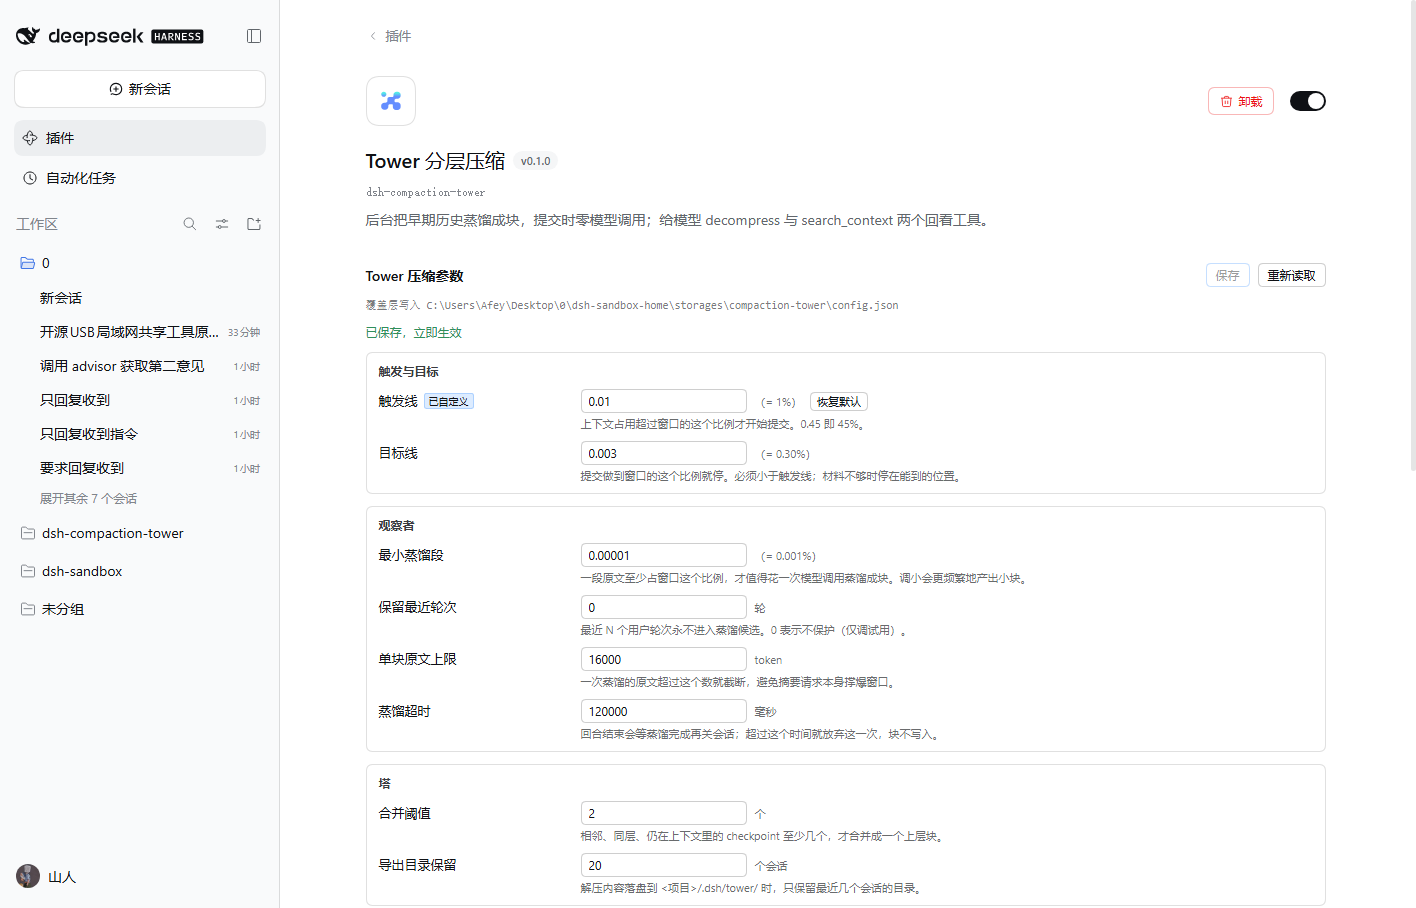
插件页里点开本插件卡片,表单直接渲染在描述下方(plugins.bundle.config 槽位),17 项按「触发与目标(2) / 观察者(11) / 塔(2) / 解压(2)」分组,每项带说明、百分比换算与「恢复默认」。观察者的 provider / model 是下拉框,候选直接取自宿主的模型目录(llm.listProviders + llm.listModels),和对话框里的模型选择是同一份数据;留空即跟随当前会话。提示词字段是三档下拉 + 只读展示。
改完点保存即时生效,不用重启。存的是稀疏覆盖,落在:
/storages/compaction-tower/config.json
优先级:覆盖层 > profile 里的 compaction-tower 条目 > 内置默认。所以「恢复默认」是把那一项从覆盖层删掉,回到 profile 写的值,而不是回到出厂值。
为什么不用宿主的 settings 服务:
settings.describe()只列出 profile 文档里的条目, 由 bundle patch 插入的行不在其中——我们这条compaction-tower正是被插进去的,拿不到表单。