Khorsheed/dsh-plugins--packages-dsh-reader ↗★ 0
@khorsheed/dsh-reader
Link reader tab: RSS/Atom subscriptions plus pasted article links, a card feed with a readable detail view, host-side fetch and daily refresh over a Typert Remote data face 适合需要在DSH内直接阅读订阅内容并划选引用至对话的用户。
インストール
npx -p @deepseek-ai/dsh dsh plugin --profile web add github:Khorsheed/dsh-plugins#548eeabe331c121621b2d08deab4278ad81d6312&path:packages/dsh-readerドキュメント
README 全文を読む ↗@khorsheed/dsh-reader
English | 中文
RSS 订阅和随手粘来的文章链接收在同一面墙上——点开就在 dsh 里读,划选就能引用进对话。
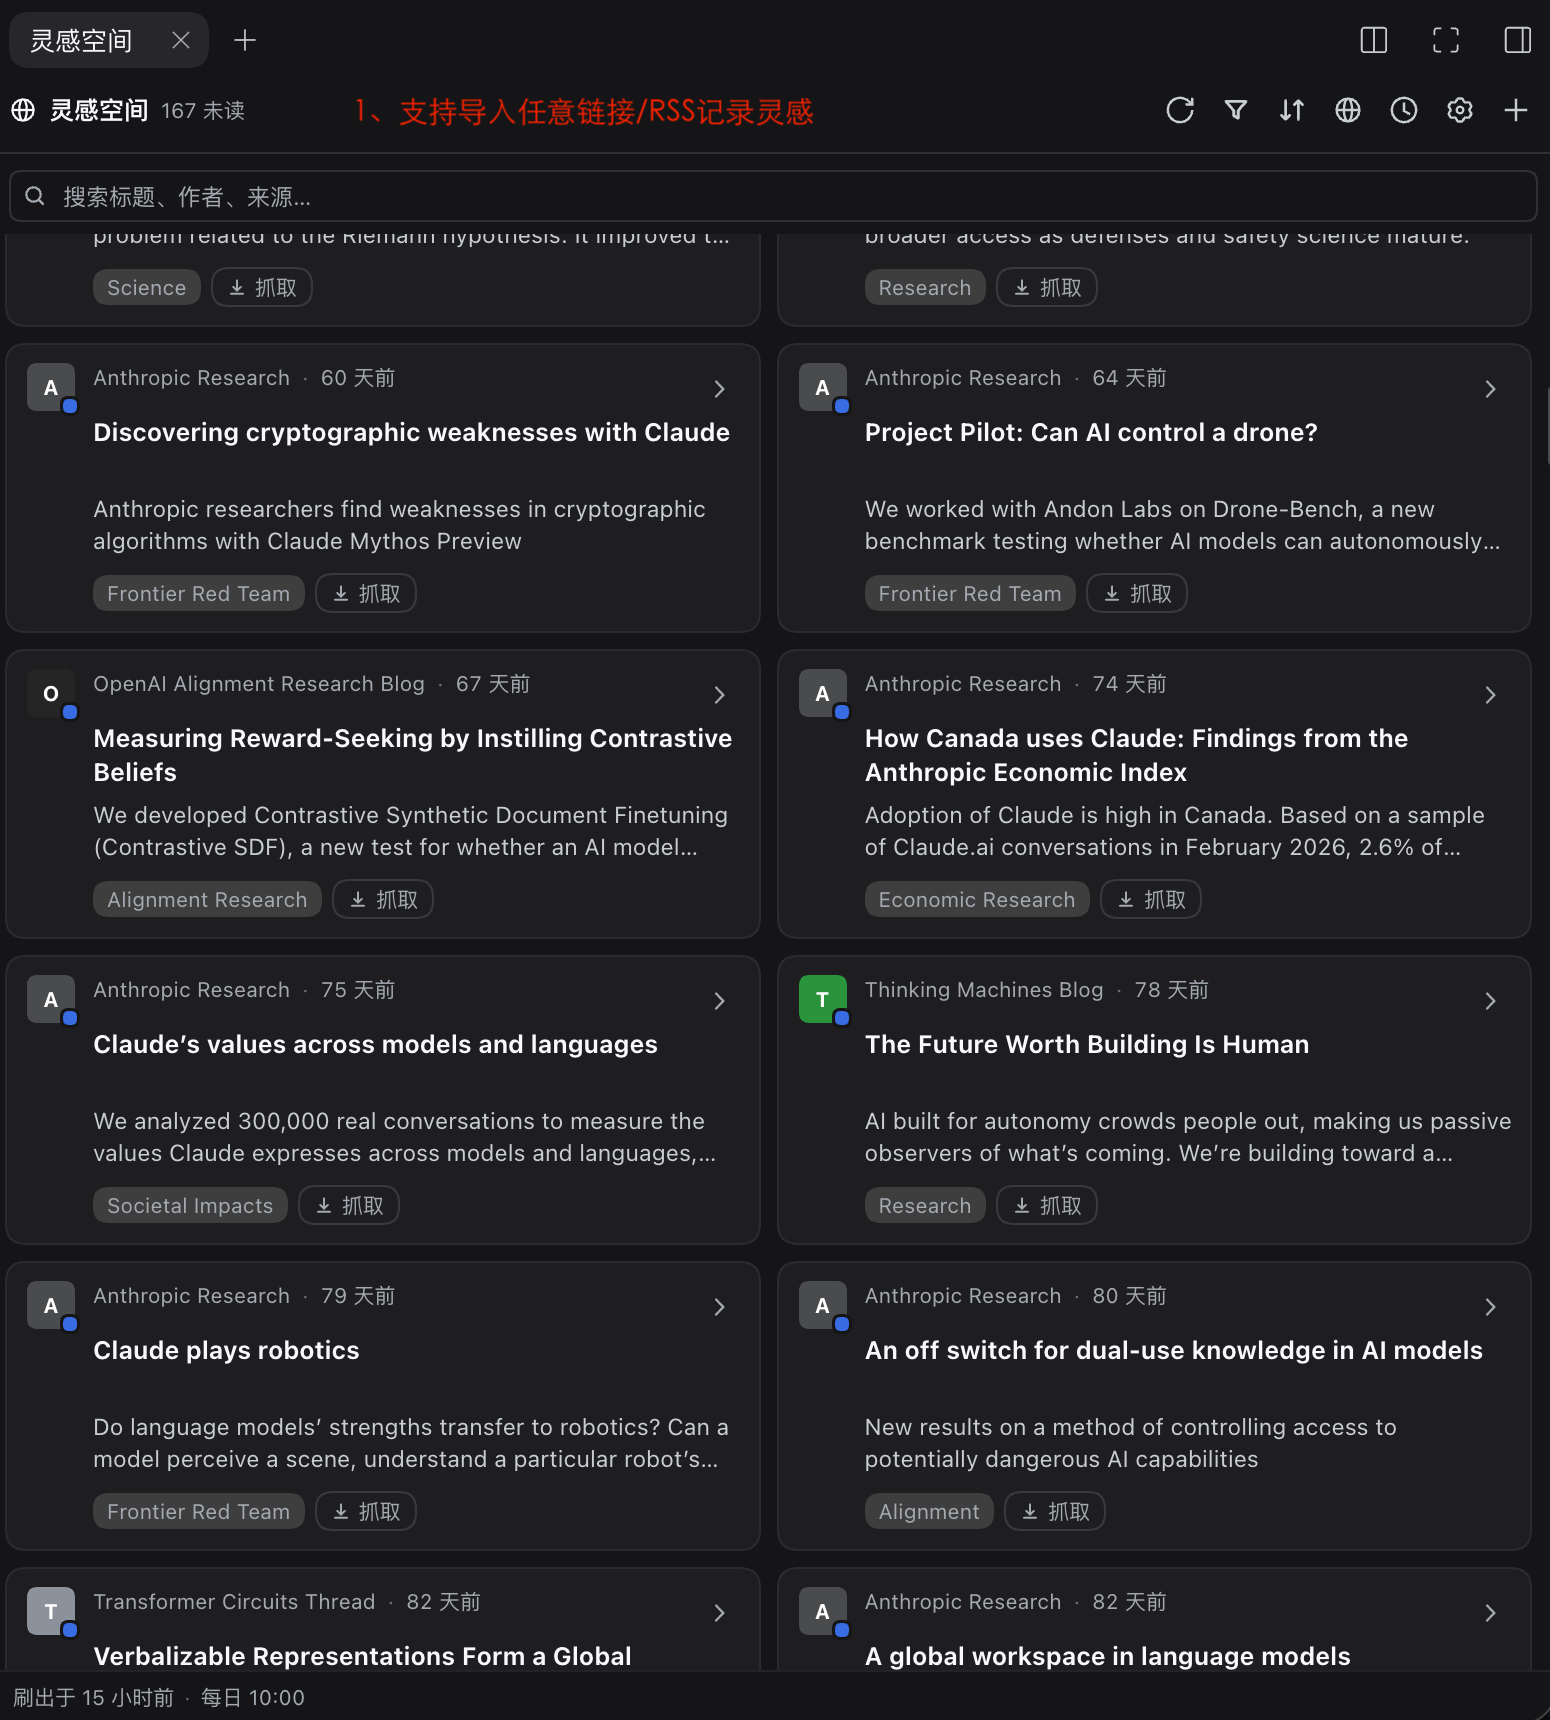
刷到的论文和文章散落在浏览器标签页里,想喂给 agent 还得复制粘贴。这个插件在右侧栏加一个页面型 tab「灵感空间」:订阅源每天按点自动刷新,链接粘进来就存成卡片;正文在 dsh 里直接渲染成可读文本(能划选引用、能用浏览器自己的端上模型翻成中文),抓不全或站点拒抓都如实标明,绝不给一堵看起来正常、实则空心的墙。
特性
- 一面墙收齐订阅和链接——RSS/Atom 订阅与粘贴的单篇文章同墙排列;文字搜索按相关性排(标题完全命中 → 标题包含 → 其它字段命中),筛选(未读 / 按来源 / 按类型 / 按标签)与搜索共用同一套本地谓词、不花请求;转载去重默认开(同条目 id / 归一化链接 / 折叠标题 + 同一发布日三层归并,任一命中即同组),幸存卡带「N 个重复来源」徽章;读者自建标签随打随用,在筛选弹层里也能删。
- 点卡片就在 dsh 里读正文——正文抽取为 DOM 文本(这正是划选引用能工作的原因):去掉与标题重复的站头,还原懒加载图片(
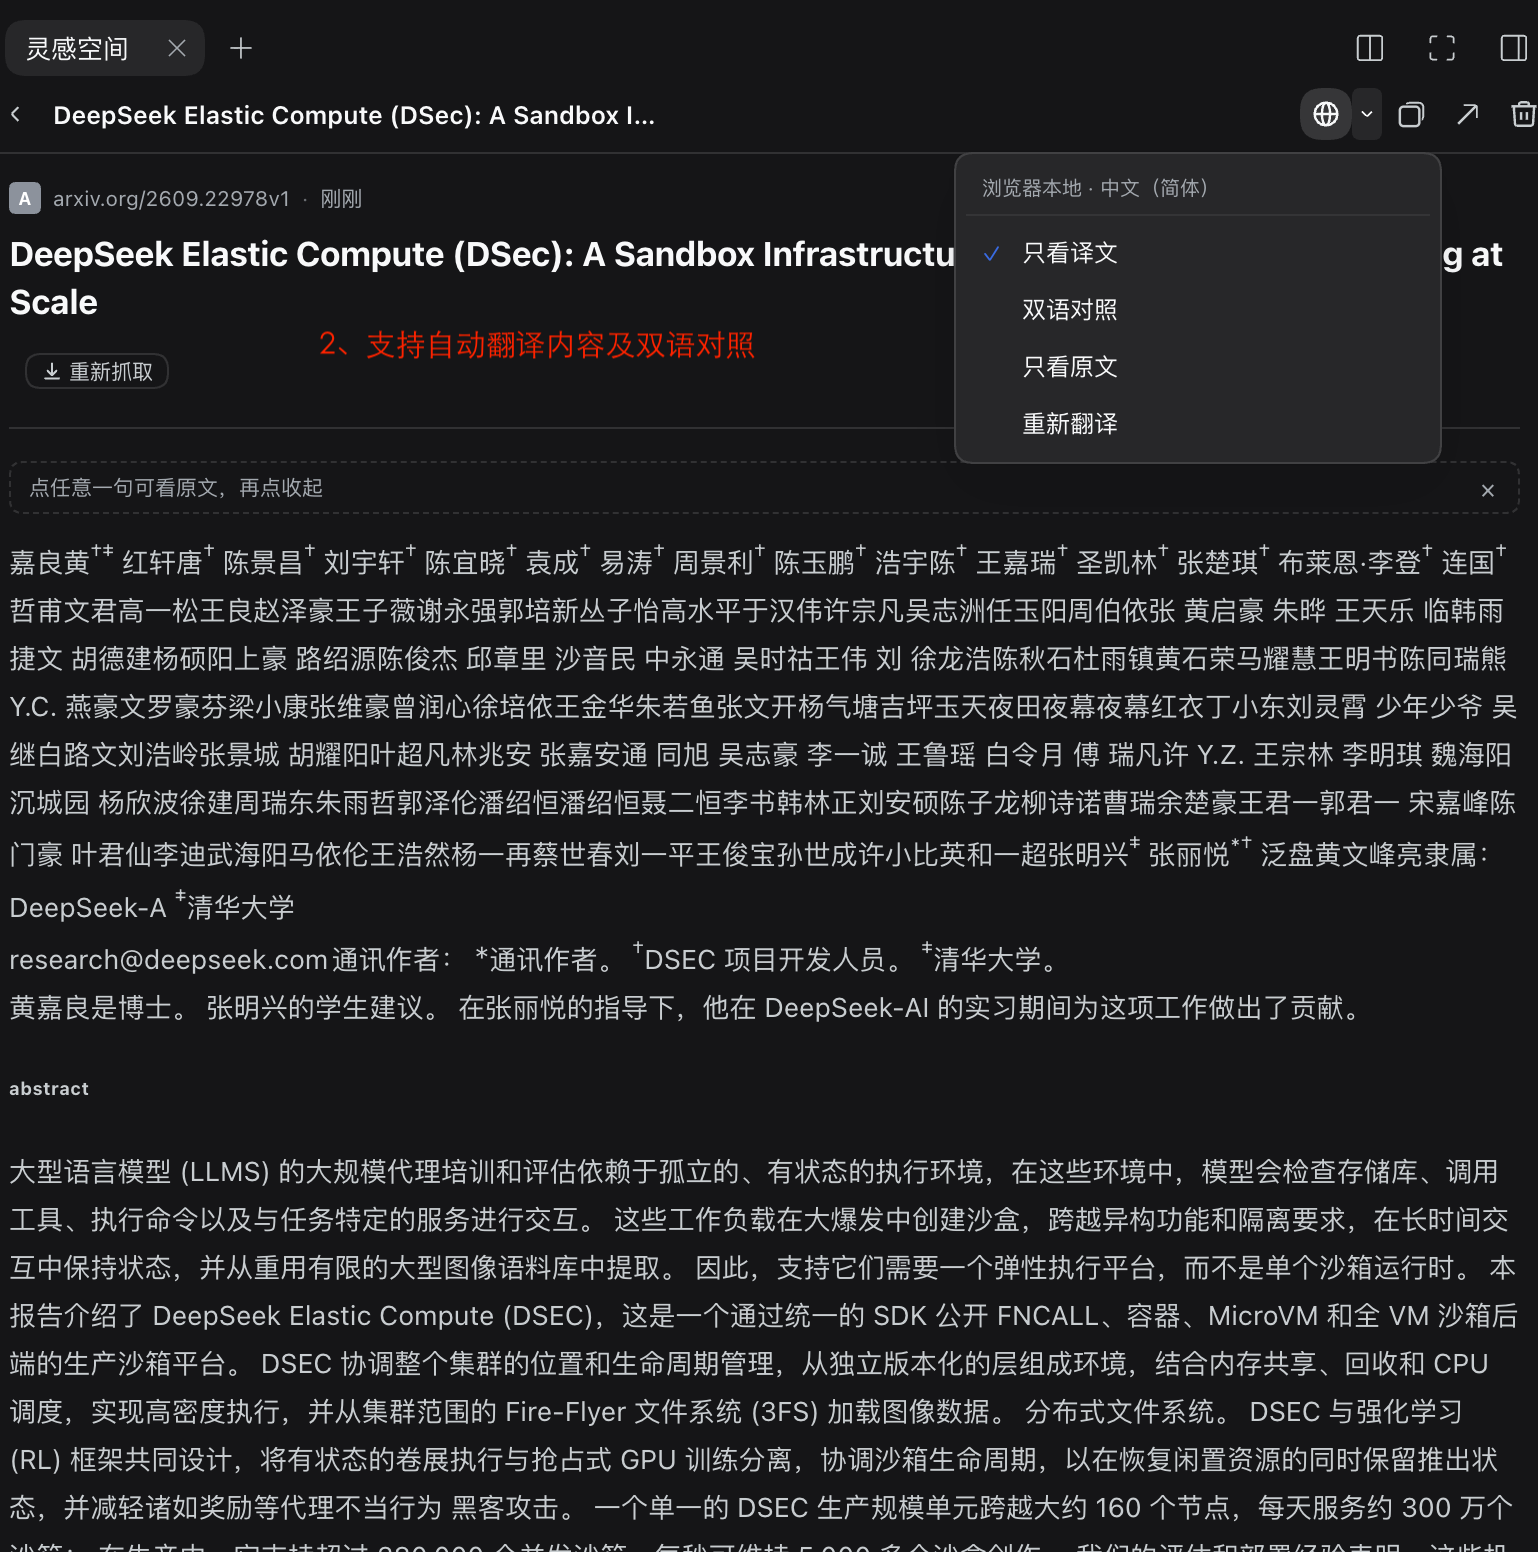
data-src/srcset/ - 端上翻译,模型不出设备——用浏览器自己的 Translator API(Chrome 138+ / Edge 148+ 桌面版),不花 token、不联网;翻译单元是句子,点一句只展开那一句的原文;三档视图(只看译文 / 双语对照 / 只看原文)。详情页与整面墙各有一个翻译开关,墙上逐字段判语言、绝不中译中。没有这个 API、语言对不可用、或正文本来就是中文时,地球按钮干脆不出现。
- 译文落盘,重开零成本——句子对写在宿主侧(全局句子记忆 + 按条目的段落映射,共享 64 MB 预算、按最近使用淘汰、无 TTL),刷新后点一下地球,整篇从磁盘重绘,模型一个请求都不发。
- 抓取跑在宿主上——卡片上的状态药丸(灰 = 未抓 / 蓝 = 抓取中 / 绿 = 已有全文 / 红 = 失败)点一下就开始,随后可以立刻离开页面:原始网页先落宿主磁盘,下次打开由浏览器半抽出正文。全文自动补齐(每次刷新最多 8 条、同时最多 2 个请求、失败 6 小时内不重试);feed 自己发布全文的条目第一次打开零请求缓存。
- 粘进来就知道是什么——是 feed 就建订阅、是网页就存单篇;arxiv 的 abs/pdf 链接自动升级官方 HTML 版;DOI 链接先解析成 arXiv 版再落地;OpenReview 直接存「仅链接」并写明原因;抓不到的地址也一定存下来,原因分档写在卡片上(反爬 / 需要登录 / 不是网页 / 跨站跳转 / 连不上 / HTTP 错误)。
- 引用进对话——正文是应用级选区,
@khorsheed/dsh-quote的浮层菜单天然覆盖它;详情页另有「引用」(选区 + 来源标签经官方输入机合入当前会话草稿,读现有草稿合并、绝不覆盖、绝不发送)与「引用到侧边对话」(组合里真有sideChat服务时才显示)。 - 订阅管理与最近阅读——管理页里每个源一行:名称与订阅地址就地编辑、单独刷新、暂停/恢复、删除,缓存策略(正文保留时长、译文预算、清空译文缓存)与存储读数同页;「最近阅读」落盘 100 条、重启还在,滚出 feed 窗口的条目也能接着读。
- 离开再回来接着读——打开的文章、按内容锚定的阅读位置(第几个块、块内第几个字符)、墙上的筛选与译文,跨 dsh 会话由整个页面记住;位置另写
sessionStorage,页面重启后仍在原处。
安装
dsh plugin --profile web add @khorsheed/dsh-reader
装完重启 web 实例后生效。卸载:
dsh plugin --profile web remove @khorsheed/dsh-reader
落盘只有一处目录:$DSH_HOME/state/dsh-reader/——state.json(订阅清单 + 最近 payload + 读者自己的标签与「最近阅读」记录)与 bodies/(超过 256 KiB 的正文各占一个文件;全局翻译记忆是其中的 translation-memory.json,超过阈值的条目译文映射也各占一个文件)。卸载后这个目录会留下——想彻底清干净就删掉整个 dsh-reader/。
Compatibility
- npm 发布线(
@deepseek-ai/dsh@0.1.5-rc.1):✅ 可用,一处设计内降级——sidebar.right.pane.tab座位、ctx.web.fetch出网缝在 0.1.5-rc.1 上完整;应用内 Sidebar Browser 出口(脚本插图提示、反爬卡片的动作)需要 0.1.6-alpha.2+ 的browser右栏 tab 类型,0.1.5 宿主上退化为普通外部链接。minHost0.1.5-rc.1;本插件不做 preset 自隐(不需要pluginInventory)。 - 源码线(deepseek-harness master):✅(verifiedHost: 0.1.5-rc.1)。
注意:宿主抓取缝默认把解码后的正文截到 100,000 字符且静默截断——这是部署配置可以抬升的上限(见「实现原理 · 抓取缝与存储」里的 patch 叠加层写法),不是插件的正文预算。
已知限制
- 只订阅、不爬全文——新增订阅只抓 feed 本身,不会为每条目预抓正文(存储会爆,而且那是在当爬虫);全文由自动补齐每次刷新补一片,或点开某条时就地抓一次。
- PDF 与其它非网页文件没有正文——宿主的出网缝只认
text/html、text/*、application/json、application/xml,application/pdf会被直接拒绝;而正文提取本来就是 DOM 的,PDF 没有 DOM。所以 PDF 链接只能存成「仅链接」的卡片 + 「阅读原文」,本插件不是 PDF 阅读器。 - 跨站跳转不跟随——宿主缝只报目标 origin、不报路径,所以换了主机的跳转(短链、ezproxy 之类的代理)一律如实报「跳到另一个站点」,不会跟过去猜。
- 未读圆点不落盘——未读标记是会话级状态,刷新或重启后全部回到未读。
- 翻译只在 Chrome 138+ / Edge 148+ 桌面版可用——Safari、Firefox、移动端没有 Translator API,这些浏览器里地球按钮不出现,其余功能不受影响(这是刻意的选择:一篇 5 万字符的长文走宿主 LLM 是几万 token + 十几秒 + 把文章再发给模型服务一次;端上翻译零成本、秒级、不出设备,质量是网页翻译级的 NMT)。
- 超大文章抽不全——宿主缝默认 100,000 字符上限(实测:Anthropic 研究页 ~266k、theverge.com ~899k、newyorker.com ~1.97M 字符),超限文章显示「受限篇幅」提示 +「阅读原文」;需要全文时由部署方抬升宿主缝上限,插件自己不会绕开宿主的出网策略。
实现原理
各个面(灵感墙 / 详情 / 翻译 / 新增 / 订阅管理 / 最近阅读,点击展开)
包名、tab kind、Remote namespace 都还是
reader—— 它们是稳定标识(改了等于改部署的 loader 行和落盘目录),「灵感空间」是用户看到的名字。
| 面 | 内容 |
|---|---|
| 灵感墙 | 内容优先:第一屏就是条目卡片流。搜索框独占一行、铺满整行宽度,筛选 / 排序 / 整墙翻译三个控件都移到表头那一行(和刷新、设置、加号在一起)——搜索框夹在三个按钮之间时,窄侧栏里连自己打了什么都看不全;每个弹层仍然挂在打开它的那个按钮下面,不会盖住另一个按钮。文字搜索按相关性排:标题完全命中 → 标题包含 → 其它字段命中,同一档里才用你选的排序(#源id / @标签id 这类选择器不参与排序),所以「搜一个标题却先出来别的」不再发生;搜索生效时底部还会写明匹配了多少条(匹配「X」N 条),列表有没有被筛过一眼可见。筛选是一个两级弹层,按「阅读状态」(未读)、「按来源」、「按类型」(订阅源 / 保存的链接)、「按标签」四种方式收窄墙:根页是阅读状态两行(只看未读、隐藏重复)、按来源 钻取行(那一行带着当前值,所以不存在「被藏起来的状态」)和类型三行。隐藏重复默认开:同一篇文章被多个源转载时折成一张卡(三层归并,任一命中即同组:同条目 id——共享 guid 按设计共享抓取/已读/译文;链接归一化——剥协议/www/utm 类追踪参数;折叠标题 + 同一发布日;绝不模糊匹配),幸存卡带「N 个重复来源」徽章(悬停列出其它来源),读过一个副本整组即已读,底部注明隐藏了几条,自动补抓也不为被隐藏的副本花请求,点进去是来源页——独占弹层高度、自己滚动、来源超过 6 个时出现自己的搜索框;所以订阅再多,弹层第一页也恒定是几行。筛选用的是和搜索同一套本地谓词(D14),所以不花请求,值就写在搜索框里(#源id / #rss / #link / @标签id)、看得见也能清掉——搜索框里有内容时框内右侧出现一个 ×,点它一次清空(筛选值和手输的关键词一起清)。墙上也能整墙翻译:工具条最右的地球(和详情页那个各自独立,共享同一份翻译记忆)。开启后逐字段判语言——中文标题/摘要原样保留、混合卡片只翻英文那一半,绝不中译中;只翻进入过视口的卡片(IntersectionObserver 喂队列、每批 6 张、按语言分组、沿用正文那套哨兵批量+校验+逐条兜底),滚回去不重复请求,进详情也不再翻一次标题。下拉两档:只看译文(鼠标悬停在被翻译的文字上时只把那个字段换回原文——标题换标题、摘要换摘要,卡片空白处/瓷贴/箭头一律不动,便于核对又不神经质)/ 双语对照(每个字段的原文常驻在译文下方,且沿用该字段自身的排版——标题原文就是标题字号与行高,靠墨色和字重与译文区分,不缩成小注)。卡片文字盒是固定的:标题与摘要各按两行预留高度并双向 clamp,所以译文/原文互换(hover 或对照)都不会改变卡片高度、网格不跳动;只有「双语对照」是显式切换、会让网格整体变高一次。条目卡片是有底、有描边、12px 圆角的卡:悬停只提亮不位移,键盘聚焦有环;未读条目标题上墨、瓷砖角上一个圆点(7px,会话级、不落盘),已读条目留在原位、只是安静一档;feed 自己的分类与读者自建标签共用同一套药丸尺寸(自建标签带描边、可折行),打标签按卡片上的「+」打开面板——里面勾选已存在的标签,或输入名字回车新建(原生 datalist 已换成可样式化的行);标签在筛选弹层的「按标签」区可以删除(每行右侧一个安静的 ×,删掉即从词表和所有条目上移除,正在用它筛选时收窄也一并清掉)。保存的链接如果读不到正文,卡片上有一个「仅链接」小徽章(虚线、安静),悬停与详情会说明原因(见下方「只能存链接的链接」)。链接卡片的标题在正文解析出来后升级成文章自己的(正文第一个 h1,否则文档标题;另带第一段实质文字当摘要),随正文写进宿主标注——正文被预算淘汰后卡片仍读这份记忆,一墙论文不用一篇篇点开。没有 publishedAt 的保存链接按它的源加入时间参与时间排序,所以刚加的那条在最上面,不会沉底。底部一行新鲜度:「刷出于 3 小时前 · 每日 10:00」,让你决定要不要按刷新 |
| 详情 | 点卡片进来。正文以 DOM 文本渲染——这正是划选引用能工作的原因,也是这个面不放 iframe 的原因。正文没有阅读量度:侧栏给多宽就铺多宽,段落和列表共用同一条右缘。工具条:返回、翻译(地球 + 视图下拉)、复制链接、在浏览器打开原文,单条保存的链接另有一个删除按钮(订阅源的条目没有:下次刷新它还会回来,给「删除」是假承诺);标题下的标签行里还有「重新抓取」(和卡片药丸同一个宿主动作,用它换一份新副本时会清掉这篇的译文记录——正文要换成新的 DOM)。正文下面列"同一来源"的其他条目。页面用脚本画的插图抓不到:这类 `` 在服务器 HTML 里只有一个空 div 和一句图注(实测 transformer-circuits.pub 这篇有 84 张),抓取不执行脚本,所以图注保留在正文里(它是页面发布的文字,写明了画的是什么),正文上方另给一行「这一页有 N 张插图由页面自己的脚本绘制,抓取时拿不到画面(图注保留在正文里)—— 阅读原文」(宿主有 Sidebar Browser 时这个出口开在应用内;未来 capture 包在场时这里还会出现「渲染抓取」——探测不到就不渲染)。capture 渲染回来的图能进正文:页面脚本绘制的图以「内联 SVG + 内联样式」到达,归一化按安全子集保留(形状/文字/defs/渐变/裁剪/symbol 复用;script/foreignObject/SMIL/事件/外部引用永不放行,url( 只许本文档片段)——而不是只剩图注。组合图的结构同样保:capture 渲染的组合图(图 + 样式盒搭的属性卡)在 figure 里保留 div/span 容器与白名单样式(布局/绘制属性;position:fixed、z-index 超限、外部 url()、脚本把戏全剥),而且任何被解包的块级容器都留下词边界——相邻文字绝不粘连。但静态标记里就有 URL 的图会回收:懒加载站点把真 URL 放在 data-src 等属性、srcset、` |
的 | |
或 `` 的 no-JS 兜底里(src里只是 1px 占位图),抽取按这个顺序解析候选、取 srcset 里最大的一张;**反过来,把真图直接内联成 base64 data URI 的页面(transformer-circuits 一类)也保**——占位图与真图按载荷大小分道(阈值 512 字符,1px gif 约 70、真图表数千起),小的照旧当占位、穿透到懒加载属性,大的原样保留;正文输出的每个 `` 都带referrerpolicy="no-referrer"(防盗链的 CDN 否则直接 403)。**LaTeXML 的矢量图也保**:arxiv HTML 把图嵌成 ``,归一化把它改写成带原始宽高的 ``;非图片的 object(PDF、视频)照旧整棵丢弃。**公式是原生渲染的 MathML**:arxiv HTML 版的 `` 按安全子集放行(annotation-xml` 与任何脚本永不放行——前者是 HTML 注射通道),块级公式横向滚动而不是顶破排版 | |
| 翻译(浏览器本地) | 工具条上的地球是开关:点亮 = 正文显示译文。它右边的下拉三档:只看译文(默认,正文上方一条一次性提示说明「点任意一句可看原文,再点收起」)、双语对照(每段下方常驻原文小字,可整段折起)、只看原文。翻译单元是句子:点一句只展开那一句的原文(段落下、左侧细线 + 高亮),再点收起,可同时展开多句;即使这句话中间夹着链接、被切成几段文本,展开的仍是完整的那一句(不会显示成碎片),原文那一行不是控件(它是给选中引用用的文本,点它不收起;点句子才收起,而且正在选区里的点击会被忽略,所以拖选原文或译文都不会把展开的原文收掉)。英文原文按正文级排版(13.5px、secondary 墨色、行距 1.62、行间 3px);它按容器位置分别排边距(段落旁:贴住所属段落,上 4px / 下 14px;列表项、引用、表格单元格里则在译文下方 5px,不会被负边距拽上去贴住译文),已展开的那一句保留一条很细的下划线(只有下划线,没有常驻底色/竖条——那是「这句绑定了下面那行原文」的安静标记);配对高亮只在 hover 时出现:鼠标移到某句中文上,这一句(含被链接切开的各段)和它对应那一行原文一起高亮;移到原文行上同理反向。默认不画任何底色或竖条 —— 试过的常驻标记会把整篇点成花的。全程在浏览器里跑(Chrome 138+/Edge 148+ 桌面版的 Translator API),模型不出设备、不花 token;译文的句子对会落盘(见下),地球开关与翻译会话不落——没有这个 API、语言对不可用、或正文本来就是中文时,地球不出现。译文两层落盘($DSH_HOME/state/dsh-reader,与缓存正文同一目录、同一敏感级、同一个卸载故事):全局句子记忆(按 →: 存原文+译文,5 万句上限)+ 按条目的段落映射(哈希→译文,键在正文哈希上,正文小幅重抓后逐句复用仍在);合计预算默认 64 MB(订阅管理页的缓存策略同一个动词可调),按「最近使用」跨两层淘汰,没有 TTL(重建一份译文要一次手势加逐句模型,不该按小时过期)。效果是:刷新后地球照样等那一下手势,手势之后整篇从磁盘重绘、模型不沾;句子在两份 schema 版本失配时读作 miss、惰性淘汰(浏览器模型升级后不会把旧译文当成新模型的产出) |
| 新增(弹窗) | 表头加号、空态卡片、墙上尾部虚线卡片三处都能打开同一个弹窗(成员 tab 的邀请弹窗同款做法:透明遮罩 + 居中卡片,Esc / 点遮罩关闭),因为「新增」是个瞬时动作,墙没必要被它替换掉。粘进去的地址存成什么由抓回来的内容决定(D15):是 feed 就建订阅,是网页就只存这一篇。arxiv 的 abs/pdf 链接自动升级到官方 HTML 版(arxiv.org/html/,LaTeXML 生成的语义标记:真表格、真公式),HTML 版不存在(404)时回退到粘进来的地址照常走。DOI 链接先解析成 arXiv 版再落地(Crossref 取标题与作者 → arXiv 标题搜索 → 标题相似度 + 作者姓重合的双因子闸;配不上就回普通路径,绝不猜),命中时卡片标注来源 DOI;OpenReview 链接不抓、直接存仅链接(实测服务器端读不到:API 在 Cloudflare 挑战后、论坛是 JS SPA),原因和建议写在卡片上(有 arxiv 版就粘 arxiv 链接)。抓不到也一定存下来:判定从「成功 / 失败」改成「已保存 + 能不能预览」,原因分档写在弹窗里(反爬 / 需要登录 / 不是网页 / 跨站跳转 / 连不上 / HTTP 错误),对应的卡片标成「仅链接」——把读者粘的 URL 丢掉,比留一张只能打开原文的卡更坏 |
| 订阅管理(页面) | 表头齿轮进入订阅管理页:顶部是一行压缩设置(每日刷新时间 + 正文保留并排,长说明收进悬停提示)与一行存储区(原文缓存读数「N 篇 · 体量」、译文缓存读数「M 篇映射 + S 句 · 体量」、译文预算输入(MB,blur/回车提交)、两步的清空译文缓存——读数是宿主聚合的,表本身不过线)与两排带小标题的筛选片(按类型:全部 / 订阅源 / 保存的链接,各带条数;排序:按添加时间 / 按名称 / 按抓取时间,默认添加时间倒序),下面每个源一行,名称与订阅地址都可以就地编辑(改地址 = 换一份文档,保存后立刻重抓,名称留空则回退成 feed 自己的标题)、类型、条目数、上次抓取时间、失败原因(按分类说人话,不是宿主缝原话)、单独刷新、暂停/恢复、删除,以及每日刷新时间的配置。这些问题是关于「源」而不是关于「内容」的,所以它们不在墙上 |
| 最近阅读(页面) | 表头时钟进入最近阅读页:按打开时间倒序列出读过的条目(标题 + 来源 + 「多久以前」),点一条接着读;右上角一个垃圾桶清空这份列表。它记的是「我刚才在读什么」,所以落盘(state.json 的 recent,最多 100 条,重开同一条只会把它挪到最上面,不会重复),刷新/重启都还在——这与面板内那份记忆(打开的文章、阅读位置、译文)是两件事:那份跨 dsh 会话共享、但不跨刷新(按页面共享,见上),recent 则是部署级、重启也在。一条记录只存条目 id、来源 id、标题、URL、时间,不存正文;因此即使那条已经滚出 feed 的窗口(源还在),这一页依然能把它打开。源被删掉的条目仍然列出,但不可点,并说明只能去原文地址开 |
卡片上的「抓取」:每张卡在标签行里有一个状态药丸——灰=还没抓(点一下就开始)/ 蓝=抓取中或已抓待解析 / 绿=已有全文(点开秒读)/ 红=失败。失败态按原因给动作:点红色药丸开一个浮层(原因 + 该原因对应的动作——连不上(网络类)给「重新抓取」;反爬 / 登录墙 / 不是网页 / 服务器端读不到给在真浏览器里打开(宿主有 Sidebar Browser 就开在应用内,否则外部浏览器);HTTP 错误 / 空页 / 跨站跳转是终局,只有原因、没有动作),卡片本身保持一行高,不把墙撑破。点「抓取」之后可以立刻离开这个页面(切到别的面板、关掉标签、刷新都行):抓取跑在宿主上,原始网页先落到 bodies/,下次打开灵感空间时由浏览器半抽出正文再缓存。所以你能先在墙上把想看的几篇点掉,再慢慢读,不必在详情页等。进入详情时如果这篇还没抓,仍然会自动抓一次(和点卡片上的「抓取」是同一个动作);已经抓过的就不再重抓——屏上那份就是缓存里的正文,重抓只会白白把 DOM 换掉、连读者已经翻好的译文一起冲走。feed 自己发布全文的条目,第一次打开就把这份全文存成正文(零请求——文字已经在屏上了),药丸在同一次手势里转绿,条目滚出 feed 窗口后正文还在。想换一份新副本,用详情页标签行里的「重新抓取」(同一条宿主路径,并清掉这篇的译文记录,见下)。
离开再回来、换个会话接着读:宿主在另一个主面板接管时会卸载整个右侧栏(RightbarRoot 只在没有活动主面板时渲染,不是藏起来),而这个面板的 store 每次挂载新建——所以「切到侧边对话再切回来」以前会把打开的正文、阅读位置、墙上的搜索/排序/筛选,以及已经翻好的译文全部丢掉。现在这些由整个页面记住并恢复:跨 dsh 会话——在另一个对话里打开灵感空间,仍然是同一篇文章、同一个阅读位置、同样的收窄和同样的译文——包括墙上整墙翻译的开关与它翻好的卡片(面板按会话挂载,这份记忆按页面共享);同一会话内从侧边对话回来也一样。恢复时那篇文章被重新打开(正文由宿主缓存作答,不花请求),阅读位置回到原处(墙和正文各自的位置都算;正文里的位置按内容记——「第几个块、块内多少像素、块内第几个字符」而不是一个像素数——因为文章自带的图片没有尺寸、会边加载边把文档撑高;正文被替换或重抓落地后会重新落回原处,原文↔译文切换改写块的高度时,也会按字符偏移重新落回同一句),译文在本页已经建过翻译会话时自动重新点亮地球(Translator.create() 需要用户手势,所以只有本页已有的会话才可能自动恢复;没有会话就不自动恢复,但记录还在,点一下地球依旧零成本)。译文跟着正文走:正文在读者脚下被替换(重抓落地、缓存过期后重取、元素被重建)时,只要这一条的地球是亮的,译文会自动重新贴回新正文(靠页面内的句子记忆,通常不花请求)。刷新(或页面重新初始化)之后,位置还在:「读到哪」这份位置(打开的条目、正文里的锚点、墙的偏移)写进 sessionStorage,所以页面重启后文章和阅读位置都会回来;地球记录与翻译会话不落盘(没有可用于恢复的会话,而新建一个需要用户手势),刷新后地球是灭的——但译文的句子对落盘了:点一下地球,整篇从宿主的两层存储重绘,模型一个请求都不发。关掉标签页即清空(sessionStorage 的作用域就是这一个标签页;宿主目录里的译文随预算淘汰,或随卸载整个目录一起删)。
点击语义(定案方案 B):点卡片 = 进详情页。大多数阅读在 dsh 里完成;正文太长或想直接看原文时,详情页自己的按钮会跳浏览器。卡片尾部的箭头是"这里能进"的提示,不是控件。
引用:正文是应用级选区,所以 @khorsheed/dsh-quote 的浮层菜单本来就覆盖它——本插件不自己造选区菜单。详情页底部另有:
- 引用:选区(没选区就是整条)+ 来源标签,经官方输入机合成进当前会话草稿(读现有草稿合并,绝不覆盖、绝不发送);
- 引用到侧边对话:只有组合里真有
sideChat服务时才显示(能力握手说了算),否则这一项隐藏。
内部机制(架构、抓取缝、翻译、存储,点击展开)
架构。 抓取在宿主半完成(走 ctx.web 这条官方出网缝),浏览器半只做解析和渲染:宿主半提供 reader 服务核心(ctx.provide('reader'))并挂出薄 Typert Remote 面(namespace reader),订阅清单与最近一次抓回的原始 payload 落在 $DSH_HOME/state/dsh-reader/state.json(用 node:fs 原子写,不走 ctx.fs,见下),每日按点自动刷新由插件自带的 setTimeout 驱动(宿主没有调度服务可骑)。浏览器半两段式注册右侧栏:先把自己铸造的 tab 类型 reader(实现 id @khorsheed/dsh-reader,带 guide 卡片)注册进 sidebarRightTabs 注册表,再经 slots.inject('sidebar.right.pane.tab', …) 把面板本体挂到 keyed 座位;中英文字典随插件注册;Remote 经 ctx.remote.$mount 自行挂载。feed 解析必然在浏览器半——宿主侧没有 XML/DOM 解析器(globalThis.DOMParser === false),getBodies 只把原始 payload 交过去。没有 static inject:每个可选能力(fs、web、sideChat、browser tab 类型、capture Remote)都在使用时探测,缺席即降级,绝不抛错。
状态为什么不走 ctx.fs:ctx.fs 是沙箱文件系统,每一次写都由调用会话的文件策略把关;workspace-write 会话写 $DSH_HOME/state 会被拒(FS_SANDBOX_DENIED,验收实例上真实发生过)。这道栅栏本身是对的、要留着;错的是把「属于部署」的状态交给一个「属于会话」的能力。所以本包按仓库里其它宿主态包的写法(packages/lab/src/state.ts)用 node:fs 原子写(临时文件 + rename),目录不可写时降级为仅内存。
Remote 面。 namespace reader,verb 分组:源管理 capabilities / listSources / addSource / updateSource / removeSource / refresh;正文 getBodies / getEntryBody / fetchEntryBody / storeEntryBody / getRawBody / entryFetchStates / listBackfillCandidates;译文 getEntryTranslation / getSentenceTranslations / rememberSentences / clearTranslations;标签 entryTags / listTags / createTag / tagEntry / renameTag / deleteTag / pruneTags;阅读记录 recordRead / listRecent / clearRecent;缓存策略与读数 getCachePolicy / setCachePolicy / getStorageStats;以及 quoteToSideChat。宿主半不解析 feed——解析在浏览器半。
来源名用 feed 自己声明的标题:宿主半不解析 feed(它没有 XML 解析器),所以新建时只能给一个从 URL 推出来的名字(就是你看到的那串 raw.githubusercontent.com/...)。浏览器半解析出 `` 后会用真实标题替换显示名,所以卡片上会出现「Anthropic Research」这样的名字,失败时回退成 URL。列表里报错时显示「{count} 天前」这种占位符也是同一类问题的另一面(参数没被插值),已修。
翻译用的是浏览器自己的端上模型,不是宿主的模型:self.Translator(Chrome 138+/Edge 148+,仅桌面版)在本机进程内翻译,所以模型不出设备、不花任何 token、不联网(首次按语言对下一次小语言包,Translator.create() 需要用户手势——点地球那一下正好是)。译文的派生句子对会写到宿主侧($DSH_HOME/state/dsh-reader 下的全局句子记忆 + 按条目映射,默认 64 MB 预算按最近使用淘汰,无 TTL;敏感级与旁边缓存的正文相同,隐私论据从来是关于网络而不是磁盘)。
翻译单元是句子,不是段落,也不是文本节点:先按句切好再发出去,配对是构造出来的真,不是事后猜的——段落级翻译拿回来是一整段,模型会合句拆句,再对齐就可能给你看错原文。批量发送时句子之间插哨兵,返回的段数对不上就把那一批退回「一句一请求」,代价是粒度,永远不是正确性。跨行内元素的句子(例如句中有链接)会变成两个单元,链接本身不动; /`` 里的内容从不翻译。
翻译器建不起来时不会假装:Translator.availability() 只是提示,不是承诺 —— Chrome 上确实出现过「availability 说能用、create() 却抛 NotSupportedError("Unable to create translator for the given source and target language")」的情况(macOS 构建有同类记录)。所以插件会:① 源语言先问浏览器的 LanguageDetector(猜错源语言正会让某些语言对建不起来,而那条报错不说是哪个语言对);② 目标语言按 zh → zh-Hans 两种写法依次真建一次;③ 全都以 NotSupportedError 拒绝时,地球自行消失并明说「这个浏览器无法翻译 en → zh / en → zh-Hans」,同时指向 chrome://on-device-internals 的 Broker State 自查;网络/配额这类非永久失败则保留地球以便重试,并报出尝试过的语言对与原因(浏览器原文里两个语言都不出现)。
正文还原是逐字节的:翻译只改文本节点(原文在内存里留着),「只看原文」和取消都能把正文还原成宿主发来的那份 HTML 原样。这也是为什么译文不会丢掉链接、图片、表格——它们根本没被碰过。
有些站点拒绝自动抓取,界面会诚实地告诉你:实测 openai.com 对任何非浏览器请求都返回 403(带代理、不带代理、换浏览器 UA 都一样,返回的是一个反机器人挑战页)。这不是抽取失败,也不是能靠重试解决的问题,所以详情页对 401/403 显示「这个站点拒绝自动抓取(原文地址对人以外的请求返回验证页)」而不是「无法提取正文」。状态码不是唯一线索:实测 openreview.net 的 PDF 链接是 302 → /challenge?redirect=… 然后 200 的挑战页——只看状态码会把挑战页当成文章存下来(这正是「加进去了但点开没内容」的根因)。所以判定是组合的:最终 URL 与请求 URL 是否变了、可见文本是否少到不像一页、以及反爬/登录页的痕迹词;命中任一条就不再存正文,改存「仅链接」。同类站点(newsletter 平台、付费墙)会有同样表现。
有的 feed 只对部分文章给全文,其余只给摘要:实测 OpenAI alignment feed 的 27 条正文从 155 字符(一句摘要)到 62,044 字符(全文)不等——这不是截断,是发布方就这么发的。摘要不再被当成全文:以前 feed 的 `` 会被塞进 contentHtml,于是条目看起来「已经有正文」——自动补齐跳过它、点开也不再抓,详情页就把那 167 字的摘要当成整篇文章显示。现在解析器给这种条目打上 summaryOnly,打开时照样就地抓一次真文章(抓取期间正文上方写明「这条订阅源只发布了摘要 —— 全文在原文页面上」,抓到之后这句自动消失),自动补齐也把它列进待补清单。重抓只在这篇还没有缓存正文时发生:summaryOnly 是 feed 条目的属性、一旦为真就永远为真,所以以前这里会让已经抓过的文章每次打开都重抓一次(用同一份正文把 DOM 换掉,译文也就跟着没了);现在只有屏上那段文字是 feed 自己给的(fromFeed)才触发抓取。
宿主一次只交接 100,000 字符,所以超大 feed 只能读到一部分:这是宿主出网缝的默认上限(web-fetch-http 的 maxBodyChars),不是插件的正文预算(插件自己的预算是单源 2 MiB / 总量 12 MiB,见 MAX_BODY_CHARS_PER_SOURCE)。你那条 feed 有 646,905 字符,宿主只给前 100,000,所以 21 条里只有落在前面那部分的两条能读到。插件无法绕过它:ctx.web.fetch 只接受 { url },没有 Range、没有自定义请求头、没有分页,插件也不会为了绕过它去 vendor fetch(那等于绕开宿主的出网策略)。要让 646 KB 的 feed 完整可读,不需要改宿主代码:用官方的 patch 叠加层给那一行加 config 即可(--patch 或机器级的 $DSH_HOME/cordis.patch.yml,后者对所有 profile 生效):
- id: web-fetch-http
  config:
    maxBodyChars: 2000000   # 默认 100000
已用 `dsh --profile web --patch --dump-co