liancha22/dsh-puzzle-mode ↗★ 2
dsh-puzzle-mode
将项目拆分为主文档与模块文档的拼图模式 适合长会话复杂项目管理,通过AI主动提问固化决定并评估项目健康度。
安裝
npx -p @deepseek-ai/dsh dsh plugin --profile web add github:liancha22/dsh-puzzle-mode說明文件
閱讀完整 README ↗dsh-puzzle-mode · 拼图模式
DSH(DeepSeek Harness)插件。把项目拆成一份主文档 + 若干模块文档, 让 AI 主动提问、把不确定项变成已定项,并在输入框的模型选择器左边 放一个显示项目健康性的小按钮。
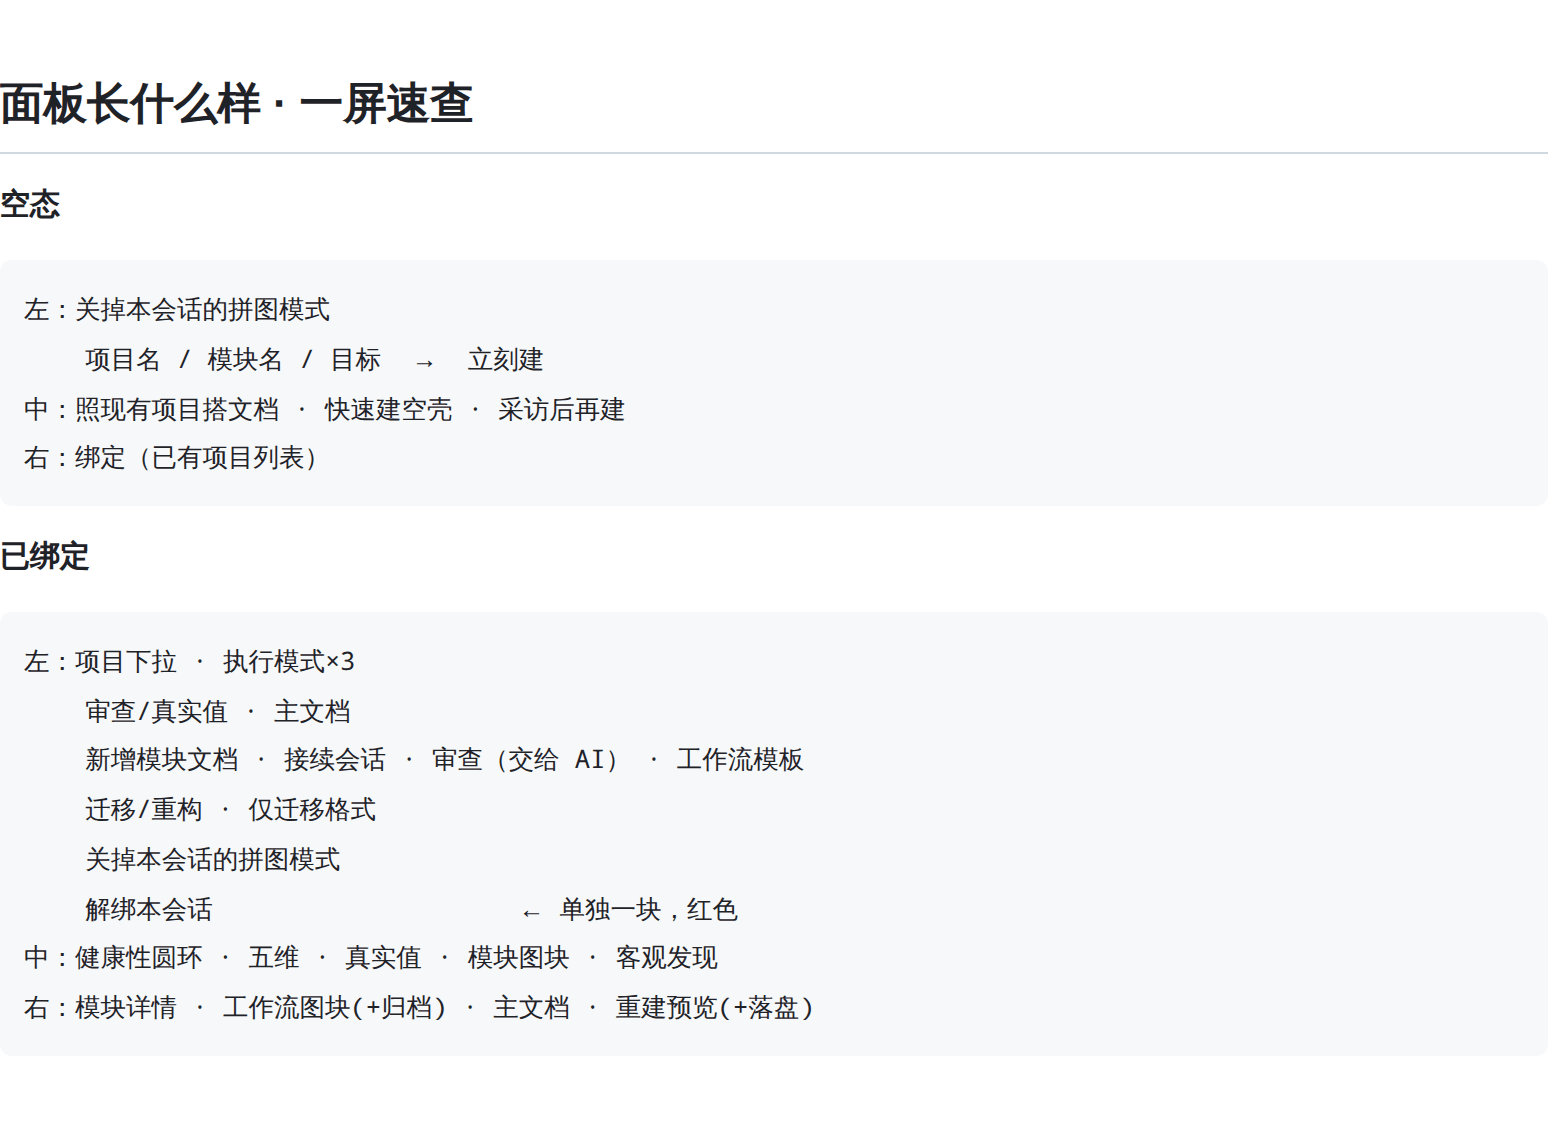
它解决什么:长会话里,项目的关键决定散落在聊天记录里——AI 会忘,你也没处查。 拼图模式把这些决定落到你随时能打开看的文件里:主文档当查找入口, 模块文档存细节,每条都带源码出处,随时能回查。
主文档的第五节 ## 工作流 是标准化流水线:为完成某个特定任务,把重复的步骤、工具、
规则按顺序串成一条可复用的路。一条工作流 = 一个 ### 名字 块,块内逐行是有序步骤。
随提示段注入,每一步都读得到;面板上图块式列出,点名字看步骤、可整条删除 / 恢复 / 永久删除。
不是独立模式:装进宿主组合后,标准模式(或任何 preset)的会话都带上它。
- 仓库:
- 最新版:v0.19.5 · 更新日志 · 所有版本
- 适配:DSH 0.2.0-rc.2(peer 覆盖 0.1.5 / 0.1.6 / 0.1.7 全部预发布版,见下)
- 面板 UI 逐块说明:UI.md —— 每颗按钮、每个区块点了会怎样
下载与安装
方式一 · 插件管理器(推荐)
python3 "$DSH_HOME/plugin-manager.py" github liancha22 dsh-puzzle-mode v0.19.5
App 的插件页「添加插件」用的就是它,也支持标签 / 分支 / 子目录:
python3 "$DSH_HOME/plugin-manager.py" github liancha22 dsh-puzzle-mode main/lib
方式二 · 直接下载附件
dsh-puzzle-mode-0.19.5.tgz (含全部源码)
方式三 · dsh CLI
dsh plugin --profile web add github:liancha22/dsh-puzzle-mode
⚠️ 装完必须重启该 profile(
patchReload: startup),再刷新浏览器页面。
本插件没有任何 npm 依赖,不需要 npm install;除运行时提供的
@deepseek-ai/dsh-tools 外不消费任何外部包。
最新版本
v0.19.5 · 把提问写深:每题 3–6 个真岔路,每个配一句取舍
v0.19.4 只做了「放开上限」。用户看过后提了下一个要求: 「最好写得有广度和有深度」——因为上限管的是数量,管不了质量:
| v0.19.4 写了什么 | 模型实际会怎么做 |
|---|---|
| 「选项别只给两三个」 | 照字面凑到 3–4 个,但没说清一个选项该长什么样 |
| (没有任何范例) | 于是很容易凑出「改 / 不改 / 再看看 / 都行」——四个选项、零信息量 |
这一版补质量,把「一句形容词」换成可照抄的骨架:
- 每题给 3–6 个真岔路,每个配一句取舍(
options[].description); - 找岔路的五个维度(广度):做法 / 范围 / 时机 / 代价 / 取舍—— 给的是找岔路的方法,不是模板;一个决策通常问得出 2–3 个维度;
- 反例:
要不要改 A?① 改 ② 不改 —— 没问出「怎么改、改多大」; - 正例(深度):
A 的改法走哪条?① 就地改(推荐):改动最小,但旧行为消失; ② 加开关并存:两套都留,代价是多一个配置项与两条路径;③ 抽新模块替换:A 退役, 但要改 5 处调用点;④ 先不改,只把问题写进文档:零风险,但问题留着。
为什么用「反例 + 正例」:模型对能照抄的骨架的遵循度明显高于形容词。正例四个选项 正好覆盖「最小改动 / 兼容并存 / 彻底重构 / 不做」,对应最常用的三个维度。
成本(提示段每 step 注入,长度直接等于每轮成本):5702 → 6057 字符,+355(+6%)。 刻意没给每个维度都配例子——那会让成本翻倍,而一个正例已经能定住形状。
v0.19.4 · 提问放开:一轮最多 10 问、每题最多 10 个选项
用户原话:「只拼不写下模型的提问感觉不够全面,不然把问题放开至 10 个,选项放开至 10 个」。
看代码,问题有两层,第二层才是根因:
| 层 | 现状 | 后果 |
|---|---|---|
| 数字太小 | 提示段写「一轮 最多 5 问」 | 问不全 |
| 压根没提选项 | 全文只有「能用选项就用选项」,没有任何选项数上限 | 模型每题只给 2–3 个选项,用户能点的面太窄 |
第二层是「不够全面」的直接来源:问题数放开到 10、但每题还是两个选项,等于没放开—— 用户照样只能在「是 / 否」里点。所以这一版同时给出选项上限,并把「别只给两三个」写进规则。
规则现在长这样(提示段 ### 提问):
一轮 最多 10 问、每题最多 10 个选项。能用选项就用选项,问的是真正卡住决定的点。 选项别只给两三个:把真正有取舍的岔路都列出来(推荐项放第一并加「(推荐)」), 用户点得到才叫问全了;同一件事只有一种做法时别硬凑选项,直接写进正文。
最后半句是防凑数:放开上限不等于每题都要凑满 10 个——只有一种做法时硬凑, 用户反而要在假选项里挑。
两个数收成一处定义(lib/constants.js 的 ASK_MAX_QUESTIONS / ASK_MAX_OPTIONS),
原先「5 问」散在多处各写一份,改一次就得满仓库找。现在提示段、首轮注入、op:init 回执、
面板三处模板与底部提示全部引用它;浏览器半 client.js 拿不到 ESM 导出,另存一份同值常量。
刻意不加校验:ask_user_question 在 DSH 核心(dsh-tool-ask-user / dsh-user-questions)
里没有任何数量校验,UI 走 options.map(...) 全渲染、卡片自带滚动。所以这两个数
只是提示给模型的软上限——插件侧拦了反而会在核心调默认值时变成误报。
v0.19.3 · 返回体积改为 ∝ 本次改变了什么
作者本人用这个插件做了一轮真实工作,一轮下来光工具返回烧掉约 193KB, 而每步真正需要的确认信息不到 200 字符。回头一量,浪费是结构性的:
| 缺陷 | 实测 |
|---|---|
| 写操作回吐整份状态 | 7026 字符(modules 占 4936),实际需 ~200 → 浪费 35× |
| 同一句证据重复 39 次 | 114 次出现、仅 12 条唯一;10 个模块的 reasons 11406 字符 → 去重后 585(19.5×) |
inflation[].because 是纯副本 | 6712 字符,逐条比对确认 100% 重复 |
| 审查指令每轮重发 | AUDIT_PROMPT 2628 字符,而提示段里已有一份同样的规则 |
根因是一条设计缺陷,不是某个字段写错:返回体积 ∝ 项目规模, 而不是 ∝ 本次改变了什么。拼图模式的项目就是靠模块数增长的——等于「越用越贵」。
修法:写操作只回回执(改了什么 + 全局几个数);证据抽成 evidenceTable
去重表,各处只留下标;inflation[].because 删除;审查指令默认不回吐(verbose:true 可取回)。
| 场景 | 改前 | 改后 | 省 |
|---|---|---|---|
| 一次写操作 | 7026 字符 | 1192 字符 | 83% |
一次 op:audit(实测响应) | 43KB | 28KB | 35% |
并把判据写进提示段防止复发:返回体积应当 ∝ 本次改变了什么,而不是 ∝ 项目有多大。
更早的版本
v0.19.2 及更早(一直到 v0.9.0)的说明已挪到 CHANGELOG.md; 每个版本的完整正文与验收判据见 Releases。
功能
1. AI 主动提问,把不确定项变成已定项
插件会往会话里注入一段规则,规定 AI 怎么问:
- 主动提问,一轮最多 10 问、每题最多 10 个选项,能用选项就用选项;
- 每题给 3–6 个真岔路,每个配一句取舍(
options[].description)。只说「① 改 ② 不改」 等于没问——你看不到代价就没法选;推荐项放第一并加「(推荐)」; - 找岔路从五个维度问:做法(走哪条路)/ 范围(改多大)/ 时机(现在做还是先记下)/ 代价(出问题怎么退、多花什么)/ 取舍(快 vs 稳、通用 vs 专用);
- 同一件事只有一种做法时别硬凑选项——那不是岔路,写进正文说明即可;
- 必须调用提问工具——在正文里写「① ② ③」不算提问,你点不到选项;
- 每次提问的最后固定问「要不要先停下?」,两个选项: ① 停下 → 只回写文档 + 一句话说明,本轮立即结束,不做任何动作; ② 继续 → 按当前模式继续。
这样你能随时喊停,而不用担心中途被改了代码。
2. 一个会话只绑一个项目
绑定信息写在主文档里,不是插件的状态文件:
---
puzzle: 5
项目: 我的项目
模式: 写后再拼
计划模块: ["登录流程","数据存储"]
会话: [""]        # 没绑定时整行不写
更新时间: 2026-09-29 12:00:00
---
归属跟着文档走:复制项目、换 profile、拷到别的机器,绑定都还在。
解析顺序只有三步:显式指定 > 本会话绑定的 > 空。没绑定就是空—— 不会自动占用别的会话的项目(早先「回退到最新项目」正是文档混成一团的根因)。
新建项目时一次同时创建工作区文件夹 + 主文档 + 每个模块一份文档。
3. 工作流 = 标准化流水线
第五节 ## 工作流 不是待办清单,也不是「别做某事」的禁令——它是为完成某个特定任务,
把重复的步骤、工具、规则按顺序串成的一条可复用的路。一条工作流写成:
## 工作流

### 发布新版本
1. 先改 `package.json` 的 version 与 `.github/release-vX.Y.Z.md`
2. 跑 `node --check lib/*.js` 确认语法
3. `git commit` 并打 tag、推送
4. 建 Release 并**单独上传** tgz 附件

### 接入新模块
1. `op:module` 建模块文档
2. `op:main section:'index'` 补主文档的模块索引行
四条硬规则:
- 一条 = 一个
### 名字块,块内逐行是有序步骤(序号由文档自动重排成1. 2. 3.); - 每条是并列的一条独立的路,两条之间不应有依赖——若两条其实是一条就合并,若要分叉就是两条;
- 要改一条就改那一块,不要新加一条;
- 最多 5 条(超了删最旧、整条进归档),每条最多 12 步—— 超步数是报错而不是删步骤(一条有序的路少一步就断了,静默删比拒绝写入危险得多)。
面板上图块式列出:只显示「名字 + 几步」,点名字才铺开有序步骤(与模块图块同一套交互); 每条可整条删除,删掉的进归档(显示名字与步数、不可展开),归档里可恢复或永久删除。
4. 三种执行模式
| 模式 | 提问 | 改文档 | 执行(跑命令 / 改代码) |
|---|---|---|---|
| 只拼不写 | 可以 | 可以 | 禁止,越权调用会被拒绝 |
| 写后再拼 | 一轮做完才问 | 可以 | 允许 |
| 边拼边写 | 每个写动作之前先问 | 可以 | 允许 |
模式名在格式 v5 换过含义:v4 及更早的
边拼边写表示「一轮做完才问」, 那个含义现在叫写后再拼;新边拼边写才是「每个写动作前先问」。 旧文档一律按旧含义读(= 写后再拼),跑一次「迁移/重构」会把名字改写落盘。 这样才不会出现「升级插件那一刻,所有旧项目静默变成每次写文件都要问」。
模式是项目级设置,写在主文档里,面板上随时切换。
5. 拼图面板
模型选择器左边一个小按钮(拼图图标 + 当前项目健康性百分比),点开是面板:
- 五维条:任务复杂度 / 可拓展性 / 维护系数 / 代码质量 / 可复用性(跨模块均值);
- 模块图块:点开读该模块文档——要点 / 悬而未决 / 已定 / 详细记录逐条成卡片,
每条带序号与出处,不合规的当场标出来(
超N字/缺出处,边框转警告色); - 客观发现直接列在面板里:三档(堵 / 补 / 提)+ 事实 + 下一步, 不必先问 AI 才看得到;
- 真实值:点一下看「声明 → 实测」逐维对照与虚高标记;
- 按钮:新增模块文档 / 接续会话 / 审查 / 工作流模板 / 迁移重构 / 仅迁移格式 / 解绑;
模板只填进输入框,不自动发送;
「新增模块文档」只在项目已有文档时用:走
op:module,不新建项目, 只在当前已绑定的项目里再加一份模块文档,并同步主文档的「模块索引」 (不写那一行,这份文档在主文档里就查不到)。 - 按会话开关:「关掉本会话的拼图模式」——按下之后这个会话下一轮起 不再注入拼图规则、也不再拦工具,其他会话照旧;再点一次恢复本会话。
新会话默认空,面板显示空态,给四条路:
| 空态入口 | 走什么 | 用在什么时候 |
|---|---|---|
| ①照现有项目搭文档 | 读工作区真实代码 → op:init + op:bind + op:source | 项目已经在工作区里(老会话、新装插件),只缺文档 |
| ②表单直建 | 面板直接落盘 | 从零建新项目,不想经过模型 |
| ③快速建空壳 | op:init | 从零建新项目,模块名已经想好 |
| ④采访后再建 | 先问最多 10 问(每题最多 10 个选项)再 op:init | 从零建新项目,目标与模块划分还没定 |
①和②③④的分水岭:①是「已有项目,补文档」,②③④是「建一个新项目」。 ①不采访(项目已经在那了,该让模型去读而不是让人从零起名),并且必须补一次
op:bind——op:init在项目已存在时返回rebound:false、不动绑定, 不补绑定面板就会停在空态,看起来像建失败了;还要显式op:source记源码根, 否则源码索引与源码体检全是空的。
6. 不想用的时候:关掉某个会话的拼图模式
总有场景你只想安安静静改个代码,不想被提问规则牵着走,但又不想卸载插件。
面板顶部的开关(或 op:settings disabled:true)就是那条退路:
- 它按会话 ID 记名单,只影响被点名的那个会话——其余会话互不干扰;
- 关掉立即生效:宿主每个 step 都重新拼装提示段, 所以本会话下一轮就不再注入拼图规则、也不再拦工具,不必等新会话;
disabled:false恢复本会话;其他会话的禁用状态不受影响;- 名单存在
$DSH_HOME/.dsh-puzzle-mode.json,跨项目、跨 profile 一致。
写文件坏掉 / 读不出来时一律当作「没禁用」:宁可少拦,也不要因为一个坏文件 让所有会话都用不了拼图。
7. 审查:给事实,也给你真实分数
审查是执行方,产出是一份可执行修复清单(fixPlan):每条
文件:行 + 现状事实(带数字)+ 具体改法 + 预期效果 + 一个复测用的 key。
| 清单类别 | 谁产出 | 说明 |
|---|---|---|
structure / doc / health | 插件(规则) | 巨函数、文件少而长、目录不分层、条目超长/无出处、虚高分 |
vulnerability(漏洞)/ redundancy(冗余) | 模型 | 插件读不到函数体语义,测不出来;模型读代码后补,用 additions 回传,插件校验后合并进清单 |
插件能测什么 / 不能测什么(prompt 里明写,不再暗示):
- 能测:文件行数与函数形状、文件数与目录分层、导出符号的文本计数;
- 不能测:真实漏洞、竞态、空值兜底、语义级冗余——这些完全靠模型读代码补。 所以「清单里没有漏洞类条目」不等于没有漏洞。
回传有校验:additions 每条必须 kind 是 vulnerability/redundancy、
target 带行号、fact/fix/expect 四段齐全——缺一整条退回(additions.rejected 里给原因),
而不是静默丢弃。复测也做实:重跑时把上一轮各条的 key 用 previousKeys 传回,
返回 recheck.resolved / recheck.remaining。
resolved只表示「清单里不再有这一条」,不等于代码改对了——改错方向或把发现藏起来也会消失。
发现分三档:blocker(数字与文档对不上,挡路)、warn(该补)、info(提示,不扣分)。
条目级问题会逐条验:v3 的字数上限与源码出处只在写入时拦, 已经躺在文档里的长条目、无出处条目不会被追溯。审查会告诉你 「某一节有几条超长、几条没出处」——否则「要点 15 条很充实」可能 实际是 15 条全超长、全没出处,数字漂亮,规格全破。
文档长什么样
//拼图/
├── 主文档.md                 # 只有五节:模块索引 / 源码索引 / 工具索引 / 坑 / 工作流
└── 模块/
    ├── 登录流程.md
    └── 数据存储.md
主文档固定五节,除这五节外不写任何内容——它是查找入口,
细节一律下沉到模块文档。其中第五节 ## 工作流 与其余四节不同:
那四节是查回来的事实,工作流是写给 AI 的行为流程(标准化流水线)。
条目格式固定为「一句话(源码: 文件:行)」,查找方向是 主文档 → 源码, 所以每条都能回查。字数上限只算「(源码…」之前那句话,出处不占额度:
| 位置 | 上限 | 条数上限 |
|---|---|---|
| 模块索引 / 源码索引 / 工具索引 | 50 字 | — |
| 坑 | 20 字 | — |
主文档 ## 工作流 | 名字 20 字 / 步骤 80 字 | 5 条,超了删最旧(整条进归档,可恢复);每条 ≤12 步,超步数报错不删 |
模块 ## 要点 | 20 字 | — |
模块 ## 可复用 | 20 字 | — |
模块 ## 详细记录 | 50 字 | — |
模块 ## 悬而未决 | 20 字 | 4 条,超了删最旧 |
模块 ## 已定 | 20 字 | 10 条,超了删最旧 |
超长是报错,不是截断——半句话落进文档比让你重写一遍更糟。 超条数是自动删最旧,不论旧项有没有澄清。
规范之外的小节会被清掉
主文档只允许那五节、模块文档只允许上表里的小节。其它小节一律算「非规范」:
它们既读不进任何 op、也不会被写入覆盖,只能靠迁移清掉。
所以 op:rebuild 会删除它们(预览里逐条列明「删了哪个、含几条」),
op:audit 也会报 unknown_section 提醒你——内容若有用,先搬进规范小节。
标题允许带说明后缀:## 源码索引(src/,共 110 文件) 仍算「源码索引」,
写回时会归一化成规范标题。但 ## 坑与决策 不算 ## 坑。
文档锁
write / edit 只要目标是 拼图/ 下的文件就会被拒绝,所有模式都一样。
原因:文档形状由插件统一维护(条目限长、条数上限、路径守卫),
一次覆盖就能把这些规则全跳过。只读不受影响。
项目健康性怎么算
五个维度,每一维 0-100、越高越好(含「维护系数」——高分表示维护负担轻):
| 维度 | 含义 |
|---|---|
| 任务复杂度 | 模块实际承担的任务量;记下的要点与细节越多越完整 |
| 可拓展性 | 还能往哪里长:悬而未决与已定越多,扩展空间越清晰 |
| 维护系数 | 维护负担轻的程度(高分 = 好维护):要点写清了才敢改 |
| 代码质量 | 坑与决策的沉淀程度:踩过的坑记下来了,质量才站得住 |
| 可复用性 | 有多少可被别处复用的东西(共享模块、公共接口、抽象) |
两条取值路径,显式优先:
- 显式写:模块文档的
## 健康性里一行一维,如任务复杂度: 80。 写维护成本: 30(成本型)会被自动翻成维护系数: 70。 - 由文档证据推导(没写时):
任务复杂度 = 要点×12 + 详细记录×10
可拓展性   = (悬而未决 + 已定)×20
维护系数   = 要点×18 + 详细记录×8
代码质量   = 坑×25 + 已定×15
可复用性   = 共享条目×30 + 要点×10

模块健康性 = 五维均值
项目健康性 = 各模块健康性的均值
这是设计意图,不是缺陷:健康性反映「已经写在文档里的证据」, 不是模型凭感觉打的印象分。空模块五维全 0,不是「看起来还行给 60」。 想让数字涨,就真的把内容写进去。
真实值:不让分数自己封自己
光有自评不够——模型刚写完代码,天然觉得自己写得好。所以审查会额外算出真实值:
真实值 = min(文档证据推导, 源码体检)
源码体检只看可测量的东西:
| 规则 | 警戒 | 硬限 | 扣分吗 |
|---|---|---|---|
| 单函数行数 | 60 | 150 | ✅ 扣(warn 10 / fail 25) |
| 文件少而总行数大 | — | ≤3 个文件且 ≥400 行 → 「一个文件装下整个项目」 | ✅ 扣 |
| 目录分层 | 6 个以上文件全在同一层 | — | ✅ 扣 |
| 单文件行数 | 800 | 2000 | ❌ 不扣,只出 info |
| 导出符号零引用 | 文本计数 ≤1 | — | ❌ 不扣,只出 info |
为什么「文件大」不扣分:工程化是一棵树,树干粗不是病。核心调度、状态机、 协议编解码天然内聚,硬拆只会让调用链横跨十个文件。健康的标准是「每个部分的职责清晰」, 不是「所有部分一样细」——一个 1200 行、30 个平均 28 行小函数的文件是健康的树干; 一个 300 行、塞了一个 260 行函数的文件才有病。行数与健康度之间没有单调关系。
所以
source_big_file只负责提示去看:大但函数都小 → 「承重模块,函数粒度健康, 不必拆文件」;大且有超长函数 → 「问题不是行数,是第 N 行那个函数」, 真问题由source_long_function承担(不重复扣分)。该拆的是函数,不是文件。
阈值是经验值不是真理:超了只报事实 + 怎么拆的下一步,由你决定。 插件只给事实,不代改——改分数与拆代码由 AI 按提示执行,且不许反过来改文档凑证据。
源码在哪:源码根
文档目录与源码目录常常不是同一处。本插件自己就是:文档在工作区,
源码在插件目录。所以有个 front-matter 字段 + op:source:
{ "op": "source" }                                        // 看现在记的是哪
{ "op": "source", "path": "/root/.dsh/plugin-src/xxx" }    // 记下来(会校验目录存在且有源码)
三级回退:显式参数 > front-matter 的 源码根: > 拼图目录的上一级。
查不到源码时如实说「没查到」,而不是把 0 个文件当成「代码很干净」。
工具 op 一览
| op | 作用 |
|---|---|
list | 列出现有项目(名字 / 模式 / 健康性 / 模块数 / 更新时间) |
read | 读状态;带 brief:true 出精简档 |
show | 读某个模块文档的详情 |
init | 新建项目:文件夹 + 主文档 + N 份模块文档,一次建齐并绑定本会话 |
bind | 把本会话绑到已有项目(旧项目自动解绑) |
unbind | 解绑本会话;文档与文件夹都留着 |
rebuild | 迁移文档格式:默认只出预览,apply:true 才落盘;正文一字不动 |
main | 写主文档五节之一:index / source / tools / pit / workflow |
module | 写模块文档小节:health / progress / points / pending / decided / reuse / detail |
health | 写五维健康性(必须带 name) |
audit | 审查:可执行修复清单(fixPlan)+ 真实值 + 虚高清单 + 最弱维度;可传 additions 回传漏洞/冗余、previousKeys 复测 |
source | 记 / 查源码根 |
workflow | remove 删整条工作流(进归档)/ restore 整条恢复 / drop 从归档永久删除 |
mode | 切换执行模式:只拼不写 / 写后再拼 / 边拼边写 |
settings | 按会话开关:disabled:true 让当前这个会话不带拼图模式(下一轮立即生效,其他会话不受影响),false 恢复本会话;不给参数只查询 |
每次返回都带 projectSource(explicit / bound / none)与 cwdSource,
「用的是哪个项目、项目根从哪来」始终可见,不会静默选错。
迁移旧文档
文档格式有版本号(当前 5)。旧文档被读到不会报错——只会分数偏低、
问题静默存在。所以 op:read 会返回 outdated: true 提醒你。
v4 → v5 会改写模式名:
模式: 边拼边写(旧含义 = 一轮做完才问) 被改写成模式: 写后再拼。预览里会明确列出这一条,落盘前能看清。
{ "op": "rebuild" }                 // 预览:逐文件列出将要改什么,不写盘
{ "op": "rebuild", "apply": true }  // 落盘
面板上有两颗按钮,分工不同:
| 按钮 | 做什么 |
|---|---|
| 仅迁移格式 | 只做机械动作:补小节、拆悬而未决/已定、删已取消的小节。先出预览,正文一字不动 |
| 迁移/重构 | 交给 AI:先迁移格式,再按规格逐节重写正文(压长度、补出处、删超限旧项) |
为什么分两颗:格式迁移是确定性的,面板自己就能做完;而正文重写必须 AI 来做 (旧条目超长、没出处,迁移刻意不追溯)。前者快,后者狠,别混在一起。
重建刻意不做的事:不改你写的正文、不自动绑定会话、不校验旧条目字数。 另外不自动备份——预览就是唯一的刹车,所以默认 dry-run。
卸载
dsh plugin --profile web remove dsh-puzzle-mode
或从 profile 的 dsh.profile.bundles 与 dependencies 里删掉那两行,重启。
工作区里的拼图文档不受影响,它们只是普通 markdown 文件。
常见问题
Q:会不会占满我的上下文?
主文档就是查找入口,配合 brief:true 与「接续会话」按钮,新会话先读入口、
按需读一个模块即可,不必通读。
Q:AI 会不会偷偷改我的代码?
在只拼不写模式下,所有执行类工具都会被宿主拒绝,理由是明确的;
在边拼边写模式下,每个写动作之前它必须先问过你(一次点头只管一个动作);
在写后再拼模式下,它先把这一轮改完,再一起汇报与提问。
另外任何模式下 write / edit 都改不了拼图文档本身。
Q:健康性分数是 AI 随便打的吗? 不是。显式写的分数与推导分数都会保留来源标记;审查还会给出真实值与虚高清单。
Q:我的文档会被锁死吗? 不会。文档就是普通 markdown,你随时能读、能复制、能带走; 只是写入要走插件(为了维持条目规格与路径守卫)。
Q:我只是想安静改个代码,不想被拼图模式管着,怎么办?
面板顶部的「关掉本会话的拼图模式」,或 op:settings disabled:true。
它只影响当前这个会话,下一轮立即生效,其他会话照旧——想恢复就再点一次。
不用卸载插件。
Q:我刚装插件,老会话里一个拼图文档都没有,要一个个手建吗?
不用。打开面板,空态第一颗按钮就是 「照现有项目搭文档」(v0.16.4 起):
它让模型先读你这个会话工作区里的真实代码,据此推导项目名与模块划分,
再 op:init 建出整套文档,并把主文档的「模块索引 / 源码索引 / 坑」
按真实的 文件:行 填好。不采访——项目已经在那了,不该让你从零起名。
Q:面板能打开,但缩在左上角 / 文字重叠 / 全透明,怎么办?
这是样式没生效,不是功能坏了。先升级到 v0.16.2 以上(修了 inset:0 简写
与 color-mix 两个坑)。若仍然如此,面板顶部会显示一行自检:
puzzle-style-diag applied= rules= inset=… color-mix=… backdrop=… min()=… ua=…
把这一行发回来即可定位(applied=false 且 rules=null 说明样式表根本没进文档,
多半是 CSP 或别的插件清了样式)。
⚠️ 若你看到的是
applied=false加四项全false,先别急着排障 —— 那多半是 v0.16.5 之前的自检 bug(applied写死、CSS被遮蔽), 与你的浏览器无关。升到 v0.16.5 再看这行。
Q:装上了但提示不兼容 / 根本没生效?
看 peerDependencies 覆盖不覆盖你的 DSH 版本。v0.16.1 修过一次声明了但等于没声明的
范围:^0.1.6-rc.1 指向一个从未发布的版本,按 semver 预发布规则把
整个 0.1.6-alpha 与 0.1.7-alpha 系列都排除在外了(13 个已发布版本里 9 个不满足)。
现在按每个 minor 锚到最早存在的预发布版,13 个全覆盖。
MIT License · 作者 liancha22